


ちょっとした導入
ドモ!あくまねこです。超お久しぶり。
現在、ふと思い立ってLojbanを喋るLLM(大規模言語モデル、いわゆるChatGPTとかGeminiとかみたいなもの)を作成しようと画策しており、その開発の日誌としてこの記事シリーズをスタートしました。ぜひよろしくお願いいたします~。
注意書き
- この記事シリーズには、多くの(主にPythonで書かれた)コードや技術的な図が含まれます。コードとか技術周り自体に興味がない方は頑張ってスクロールしてその部分を飛ばしちゃってください。
Qii〇aでやれ?それはそう... - また、コードの作成にはClaude Sonnet 5.5を使用しています。AI生成物に関して苦手意識のある方はご容赦ください。
機械学習に興味があまりないよ~って方も、言語学的な方面から楽しめるようにLojbanの説明も交えつつ頑張って記事を書くつもりですので、読んでいただけますと幸いです!
LojbanでLLM作るってどういうこと?
さて、早速本題ですが...皆さんは「こいつ、LLMを作るのになぜ多々ある言語の中からLojbanを自力で喋れるわけでもないのに選んだのか?」という疑問をお持ちだと思います。
その答えは...
私「ウワ文脈わからないと読めない英文だ 許さない(憤怒)」
私「それに比べてLojbanはいいよね、文法が厳格に決まってて。文章の意味あんまり読まなくても自動的に構造を決定できる言語そうそうないよ」
私「...ん?自動的に構造を決定できる?それってつまり文脈理解のための機械学習の負担を減らせるから軽量なLLM作れるんじゃない!?」
...ということで、「LojbanはLLMとの相性がいい」という仮説のもと、膨大な計算によって文脈判断している通常のLLMとは異なり、文章内の単語の繋がりを事前に処理してAIに渡すことで軽量なLLMを作ろう!と考えたのがキッカケとなっています。
では、そのLojbanがどういう形式の言語なのか、少し解説したいと思います。
Lojbanってどういう言語?
Lojbanは、James Cooke Brownが創始者であるLoglanという人工言語を前身として、Logical Language Group(LLG)が開発を行っている人工言語です。柔軟な形式であいまいさのない文章が書けるため(マジですごい)、芸術分野にも理論的な分野にも応用できるという特徴を持っています。
基本的には、Lojbanの文(正確には命題。bridiと呼ぶ)は、「~である(名詞)」「~する(動詞)」「~しい(形容詞)」などの文章の中心となる意味を持つ要素のselbriと、そのselbriが関係を指し示す項目であるsumtiで構成されています。
例えば、「私が市場に行く」という意味のbridiでは、以下の通り...mi(私)とle zarci(市場)というsumtiについて、klamaというselbriが「mi(私)がle zarci(市場)に行く」という関係を示しています。
| 文章 | mi | klama | le zarci |
|---|---|---|---|
| 意味 | 私 | ~が~に行く | 市場 |
| 種類 | sumti | selbri | sumti |
Lojbanが面白いのは、同じ単語をselbriにもsumtiにも使えるところです。例えば、先ほど出てきたzarciは、selbriとして使うと「~は市場である」の関係を表し、laをくっつけてla zarciというsumtiの形にすると「市場」という意味になります。
そうです。この言語にコピュラ文とかいう概念はありません。すごい
では、どうやって「この単語がsumtiかselbriかどちらか」「どのsumtiがどのselbriに対応するのか」「このsumtiはselbriが指す関係のうち、どこに当てはまるのか」などを判別するのでしょうか?なんと、Lojbanにはかなり厳格な文法ルールがあるので、ある程度は文脈要らずで機械的に判別することができるのです!
LLM実装に向けてどういうことするの?
Lojban文の構造を把握するツールを作る
Lojban文の文章構造のうち、「この単語がsumtiかselbriかどちらか」「どのsumtiがどのselbriに対応するのか」については、なんと偉大なる先人の方々がLojban文を構造木にしてくれるcamxesという自動判別ツール(パーサと呼ぶらしいです)を公開されています。本家はJavaというプログラミング言語で作られているみたいですが、私はPythonという言語しか分からないので...偉大なる先人の方がcamxesをPythonで再現したcamxes-pyを使用させていただくことにしましょう。
今回のプロジェクトでは、このcamxesを拡張して「このsumtiはselbriが指す関係のうち、どこに当てはまるのか」についても処理できるようにしたいと考えています。
LLMに文法の情報を渡したり、LLMが文法に則って出力できるようにする
camxesの拡張がうまくいったら、LLMがその情報を活用できるような仕組みを作ろうと考えています。
現在主流のLLMで使われているTransformerと呼ばれる仕組みは、読み込んだ文章を単語単位で分割し、単語それぞれに文章内での位置(何番目の単語か)の情報を追加した後(Positional Encodingと呼ぶ処理です)、機械学習の力で文脈を判断し(Attentionという仕組みを使います)、その文脈から次にくる確率が高そうな単語を予想して出力することで文章を生成しています。
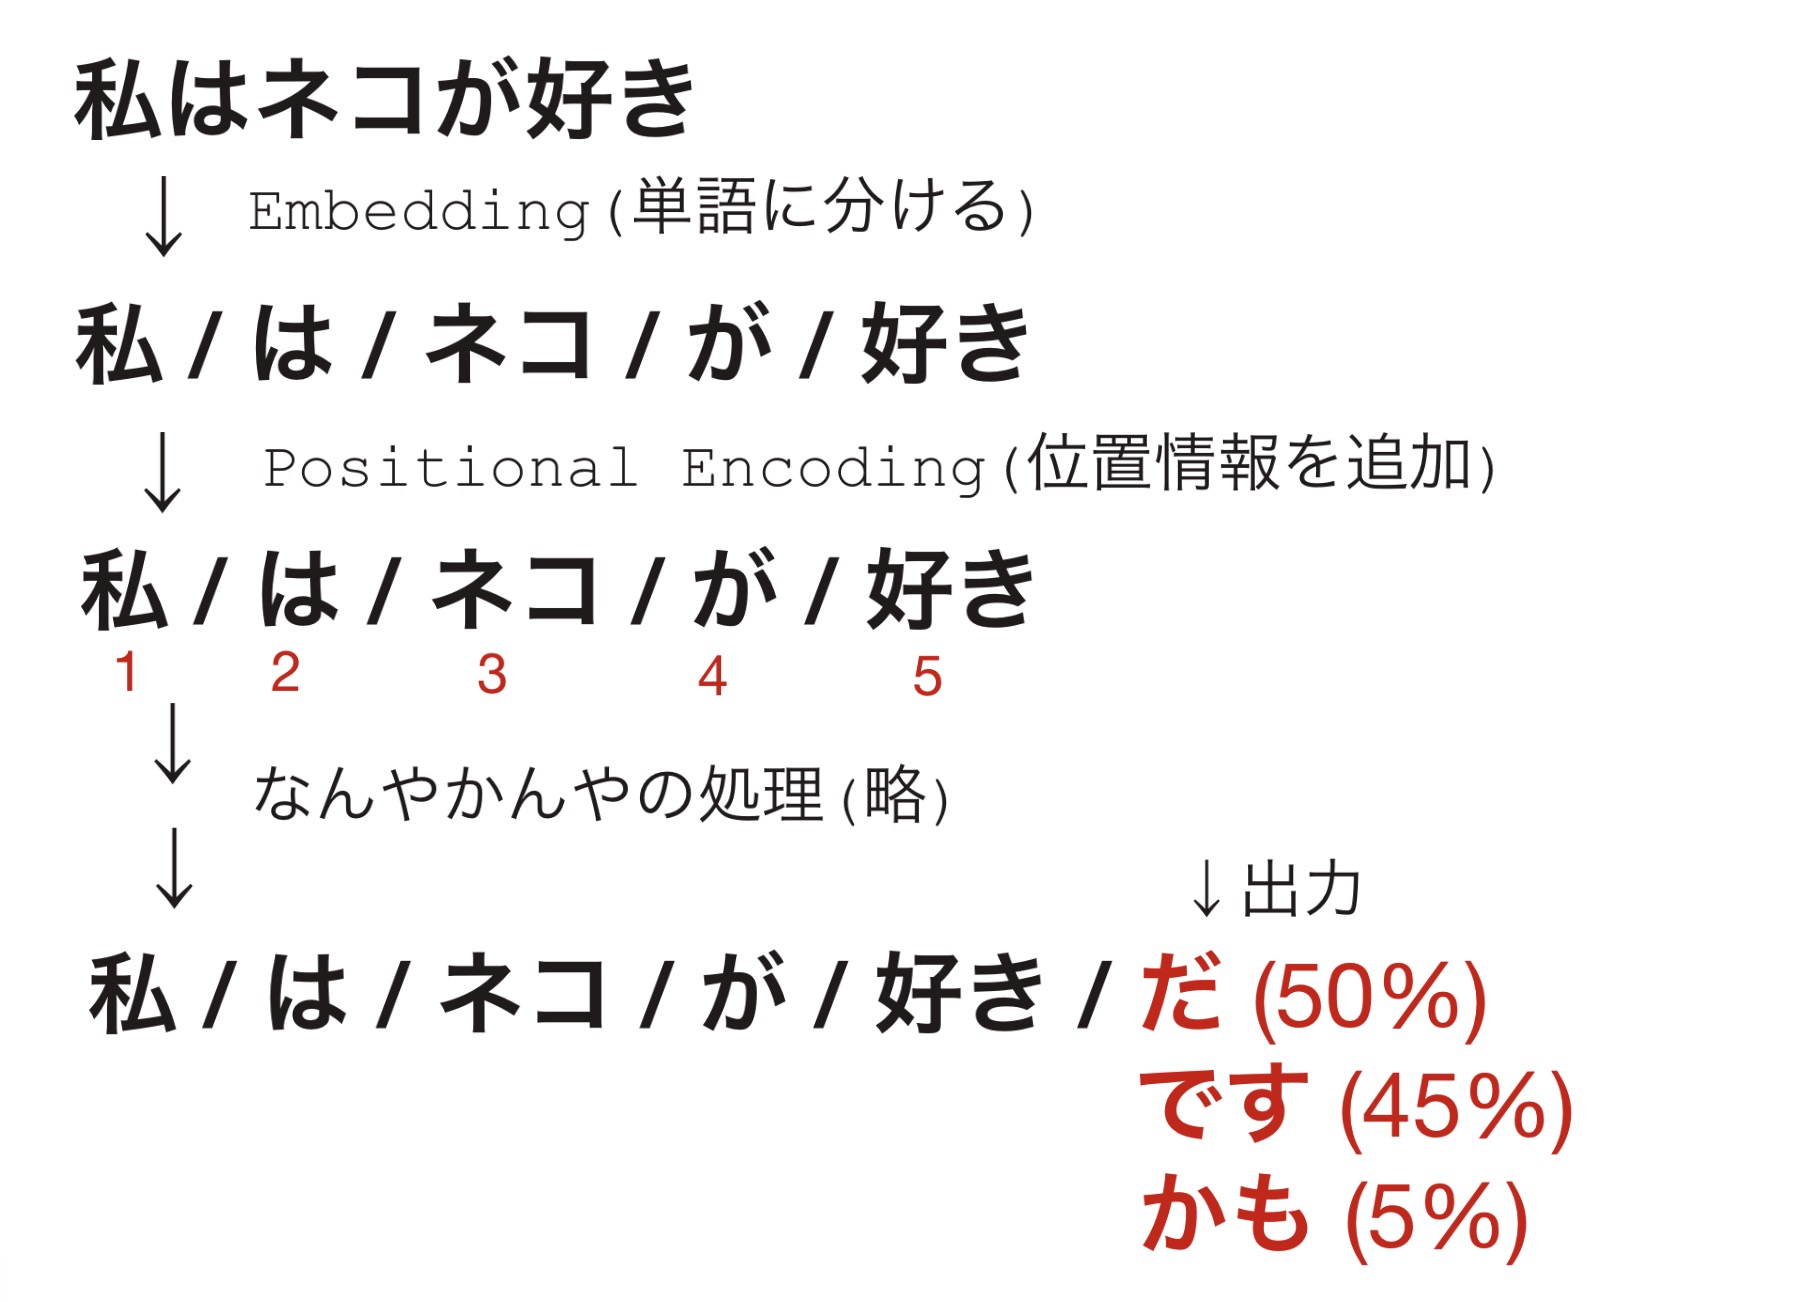
しかし、この仕組みそのままだったら、折角情報としてまとめたLojbanの文法構造を文章生成に応用することができません。なので、LLMが文章を読む部分と、LLMが文章を出力する部分にちょっとした工夫を加えようと思っています。
LLMが処理する単語に、位置だけじゃなくて文法の情報も埋め込む
LLMが文章を読む部分の工夫として、単語それぞれに文章内での位置(何番目の単語か)の情報を追加する機構であるPositional Encodingを、文章内での位置の情報だけでなく、拡張したcamxesによって判定した文法構造の情報もねじ込めるように改造することにします。文法構造の情報をどうやって単語の情報に足せる形にするかについては未定ですが...まあ追々考えましょう。
表現の自由さを保ったまま文法的に正しい文だけを生成するようにする
LLMが文章を出力するとき、どうしても「次に来そうな単語を予測する」という仕組みのままだと、文法のことを考えてるわけではないため間違った文を生成してしまうリスクがあります。
なので、Lojbanの表現の自由さや文章の内容をLLMが自由に決められる仕組みを保ちつつ、正しい文法構造の文章を出力させるため、bridiごとに「selbriとsumtiの組み合わせ」⇒「その表現に付属させる装飾」の組み合わせをLLMに出力させ、その後機械学習ではないプログラムを使ってちゃんとしたbridiの形に整えるという方法を取ることにします。さらに、生成する単語の選択肢を、事前にその位置に置いても文法エラーにならない単語に絞ることで、LLMが変な位置にありえない単語を生成してしまう事故を防ぎます。
出力の具体的な形式については一旦後回しするということで...。
まとめ、と後書き
- Lojban、すごく文法が厳格なので、文脈理解をある程度楽した軽量なLLMを作れるかも
- 今後はcamex-pyをsumtiの役割まで判別できるように拡張する
- camex-pyを拡張できたら、LLMにうまいこと組み込む仕組みを作る
まだ構想段階のアイデアや解決すべき課題も山積みですが、ひとまずこの方針をロードマップとして開発を進めていこうと思っております。
次回はcamex-pyの拡張に片足を突っ込む予定です。実際のPythonコードとかも使いながら解説していくので、ぜひお付き合い頂けますとSuper幸いです。
機械学習に詳しい方とかLojbanに詳しい方、もし何かアドバイスとかご指摘とかがあればジャンジャンお願いします!!かなりエアプのまま開発してるので
それでは、また次回の記事で~!!
参考文献
- The Complete Lojban Language. (n.d.). Lojban.org. https://lojban.org/publications/cll/cllv1.1xhtml-section-chunks/index.html
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30. https://doi.org/10.48550/arXiv.1706.03762
ちょっとした個人的な話(飛ばしていい)
Migdalに登録した当初は受験生の立場だったため、数学や理科にキレ散らかしながら「お前を理解するためだけの言語体系を作ってやる(怒)」と息巻いていたんですけど、普通に受験勉強で忙しくてMigdalから離れている間に数学・理科とはマブダチになることができ、なんなら志望校にも受かってウハウハになってました。その結果Migdalのこと忘れて2年近く放置してたのは...まあ...
で、色々余裕ができた今、過去の私が学習途中で挫折した言語であり、私が作ろうとしていたオリジナル言語よりもよっぽど論理的な言語であるLojbanに改めて向き合って勉強して、あわよくばLojbanを喋るLLM作りたいな~~~と思ったので記事を書いてみることにしました。ひさしぶりすぎるし前の記事が初投稿の記事なせいでこれでいいのかわかんにゃい。
こんな感じでゆるりと記事を作成していきますので、今後とも宜しくお願い致します。

人気順のコメント(0)